
Wpisz w Google „jak wybrać materac”. Dostaniesz dziesięć poradników, które różnią się głównie logo w nagłówku. Nad nimi zobaczysz AI Overview, które streszcza (w uproszczeniu) wszystkie dziesięć naraz. I tu pojawia się pytanie, na które branża odpowiada niechętnie – po co użytkownik miałby kliknąć w tekst, jeśli odpowiedź nad wynikami daje mu dokładnie to samo?
Commodity content, czyli poradnik, który napisał się sam
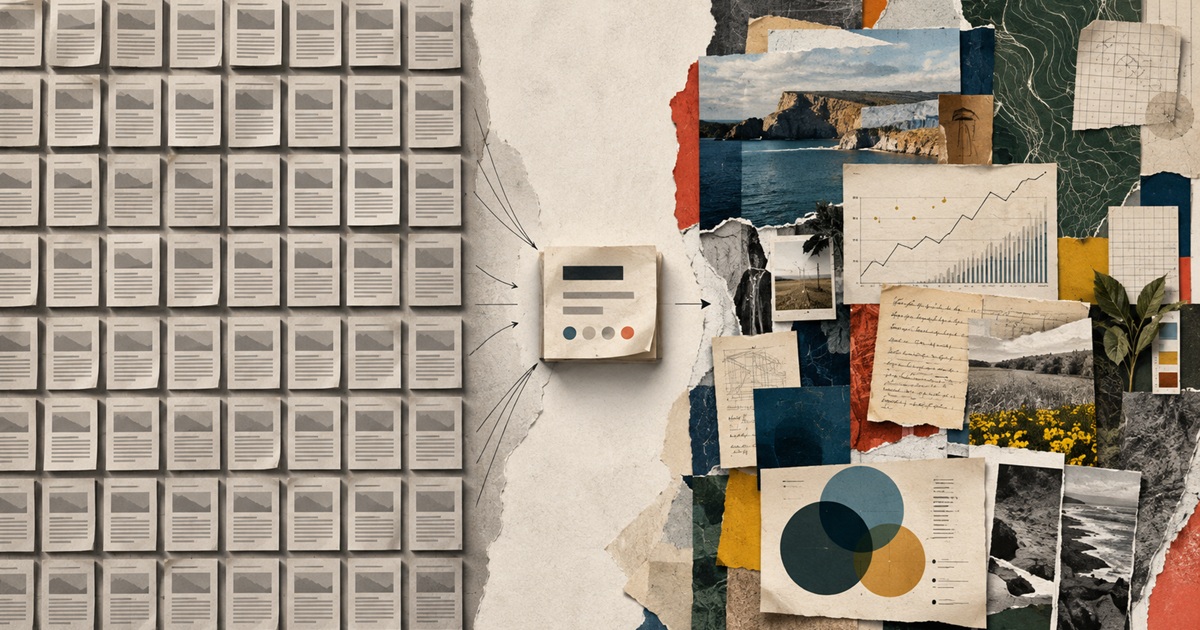
Commodity content to treść, która mogła powstać bez wychodzenia z domu, bez rozmowy z klientem i bez otwierania własnych danych. Autor przeczytał TOP10 Google, wyciągnął część wspólną, dodał FAQ i kliknął „publikuj”. Google mówi dziś o tym znacznie bardziej otwarcie – samo przetworzenie tego, co już istnieje w sieci, nie jest wystarczającym powodem, żeby to właśnie Twój materiał był najbardziej użytecznym wynikiem. W swoich materiałach dla twórców Google wprost zachęca do tworzenia non-commodity content — treści opartych na własnym doświadczeniu, analizie i punkcie widzenia.
Test streszczenia. Jeśli model zrobi to w trzech zdaniach, problem masz Ty!
Najtańsza metoda oceny, jaką znam. Wklejasz gotowy tekst do dowolnego LLM-a i prosisz o streszczenie w trzech zdaniach. Potem zadajesz drugie pytanie: czego nie dostanę, jeśli przeczytam tylko to streszczenie?
Dobry tekst też da się streścić. Różnica polega na tym, że po streszczeniu nadal zostaje powód, żeby wejść do źródła: tabela z danymi, metodologia, zdjęcia, screeny, pełny case, wypowiedź eksperta albo detale, których nie da się zmieścić w trzech zdaniach. Jeśli po streszczeniu użytkownik dostał całą wartość artykułu, problem zaczyna się właśnie w tym miejscu.
Sygnały ostrzegawcze widać jeszcze przed testem: zero własnych liczb, zero nazwisk, zero „u nas”, zero porażek, a co trzeci akapit zaczyna się od „warto”. Jeśli do tego artykuł nie jest podpisany imieniem i nazwiskiem, wynik takiego testu łatwo przewidzieć.
Przykład nr 1
Waga zamiast objętości
Przez lata content wygrywał masą: 4000 znaków biło 1500, FAQ biło brak FAQ. Działało, dopóki objętość była kosztem. Dziś jest darmowa, więc przestała cokolwiek sygnalizować.
Zostały elementy, których model nie może sam wiarygodnie dostarczyć, jeśli ich od Ciebie nie dosta.
1. Dane własne
Przeanalizowaliśmy ponad 200 kart produktowych sklepu na IdoSell i sprawdziliśmy, które zmiany w opisach faktycznie przełożyły się na widoczność. Najciekawszy wynik nie dotyczył długości tekstu, tylko doświadczeń użytkowników z produktem oraz praktycznych wskazówek dotyczących użytkowania.Takich informacji nie da się znaleźć przez zwykłe przeklejanie informacji z wyników TOP10.
2. Doświadczenie
Jeszcze ciekawiej robi się wtedy, gdy wdrożenie, produkt, usługa czy hipoteza – nie działają. Artykuły poruszające temat błędów, pomyłek czy „porażek” właśnie dlatego są wartościowe, bo nie powstały przy biurku. Porażki bywają o tyle cenniejsze od sukcesów, bo dużo rzadziej trafiają do cudzych poradników.
3. Cytaty ekspertów
Prawdziwa rozmowa z konkretną osobą, z imieniem i stanowiskiem. Ekspert bez nazwiska to figura retoryczna.
4. Obserwacje z rynku
Sprawdź, co wydarzyło się na Twoich projektach po zmianie, o której piszą wszyscy. Nie „AI Overviews zmienia SEO”, tylko: na ilu frazach je widzisz, co stało się z CTR-em, które typy zapytań ucierpiały, a które nie. Model może opowiedzieć o trendzie. Nie siedzi w Twoim Search Console.
Przykład nr 2
Information gain w redakcji, czyli co robić, zamiast pisać „jesteśmy ekspertami”?
Nie używam tu „information gain” jako nazwy kolejnego potwierdzonego czynnika rankingowego. To raczej zasada redakcyjna – po przeczytaniu naszego tekstu użytkownik powinien wiedzieć coś, czego nie wiedział po przeczytaniu tekstów konkurencji. Eksperckość słabo działa jako deklaracja. Znacznie lepiej funkcjonuje jako skutek uboczny tego, co pokazujesz w tekście. Jak zadbać o information gain?
1. Jedno pytanie do klienta przed tekstem
Piszesz o wizytówkach Google? Dzwonisz do kolegi z branży i pytasz, co go ostatnio zaskoczyło. To zdanie zwykle jest warte więcej niż reszta artykułu. Nie pytasz „co jest ważne w wizytówce?”, bo dostaniesz odpowiedź z poradnika. Pytasz „co wydarzyło się na którymś profilu w ostatnim miesiącu, czego się nie spodziewałeś?”.
2. Mini-badanie zamiast researchu w Google
Masz GSC, GA4, panel sklepu, historię rozmów z klientami. Zamiast pisać kolejny tekst o czynnikach wpływających na widoczność wizytówki, wybierz 30 profili klientów i sprawdź jedną zależność: liczbę opinii, częstotliwość nowych recenzji, kompletność profilu albo odległość od punktu wyszukiwania. Nawet jeśli wynik brzmi „nie znaleźliśmy wyraźnej zależności”, masz coś, czego nie daje standardowy research.
3. Screen zamiast opisu
Piszesz o narzędziu? Pokaż jego wynik na własnym projekcie, nie grafikę od producenta.
4. Zasada nieskopiowalnego fragmentu
Każdy tekst powinien zawierać przynajmniej jeden fragment, którego konkurent nie może skopiować bez wykonania własnej pracy. Może to być wynik analizy, zdjęcie z wdrożenia, decyzja podjęta na projekcie, cytat z rozmowy albo obserwacja z danych. Jeśli jedyną „oryginalnością” jest inne sformułowanie tego, co już znajduje się w TOP10, tekst nadal jest commodity.
Przykład nr 3
AI jako researcher i twórca struktury, nie jako copywriter
Nie chodzi o wyrzucenie AI z procesu, tylko o przesunięcie jej o dwa kroki wstecz. Poniżej schemat, na podstawie którego możesz tworzyć treści non-commodity z wykorzystaniem AI:
- AI rozbija temat na pytania, które zadaje użytkownik (klasyczny fan-out).
- AI analizuje TOP10 i wypisuje, co już tam jest. Potem dzielimy te informacje na trzy grupy: rzeczy, które użytkownik musi dostać; rzeczy powtarzane przez wszystkich bez większej wartości; pytania, na które konkurencja nie odpowiada.
- AI proponuje strukturę.
- Człowiek dostarcza materiał, którego model sam nie ma: dane, case study, cytaty, screeny, obserwacje z projektu, zdjęcia, infografiki, filmy.
- AI dokonuje finalnej redakcji treści.
Ironia sytuacji: jeśli poprosisz model o „artykuł ekspercki”, ale nie dasz mu własnych danych, rozmów ani materiałów z projektu, najczęściej dostaniesz bardzo sprawnie napisaną wersję tego, co już wiadomo. Model nie zna rozmowy, którą odbyłeś wczoraj z klientem, wyniku testu sprzed tygodnia ani nietypowego przypadku z ostatniego wdrożenia, dopóki mu ich nie pokażesz. Jeśli AI tworzy całą pierwszą wersję tekstu, a człowiek dopiero później próbuje „dodać eksperckość”, proces zaczyna się od złej strony.
Nie każda treść musi odkrywać Amerykę
Nie każdy adres URL w obrębie strony potrzebuje własnego badania i wypowiedzi trzech ekspertów. Cennik ma podawać cenę. Instrukcja zwrotu ma wyjaśniać zwrot. Opis kategorii ma przede wszystkim pomóc użytkownikowi dokonać wyboru.
Problem zaczyna się wtedy, gdy publikujemy kolejny poradnik z ambicją zdobywania ruchu informacyjnego, ale jedyną rzeczą odróżniającą go od konkurencji jest inny nagłówek H1 oraz bardziej rozbudowane FAQ. Non-commodity content nie oznacza obowiązku produkowania researchu do każdego akapitu. Oznacza świadomość, gdzie powtarzalna informacja wystarcza, a gdzie potrzebny jest powód, żeby wybrać właśnie nasze źródło.
Przykład nr 4
Checklista, która pyta „a co tu jest nowego?”
Klasyczna checklista SEO (nagłówki, linkowanie wewnętrzne, meta dane, schema) jest nadal potrzebna, ale sprawdza tylko to, czy tekst da się znaleźć. Nie sprawdza, czy jest po co. Dlatego obok niej warto utworzyć drugą kolumnę:
- Ile faktów w tekście pochodzi z naszej pracy, a ile z cudzej?
- Czy jest w tekście informacja, przykład albo materiał, którego konkurencja nie może pozyskać bez własnej pracy?
- Czy ktoś wypowiada się z imienia i nazwiska?
- Czy pokazujemy również coś, co nie wyszło lub sprawiło problem?
- Czy po przeczytaniu streszczenia nadal istnieje konkretny powód, żeby wejść do pełnego tekstu?
- Czy autor podpisze się pod tym nazwiskiem i pochwali na LinkedInie?
Jeśli w drugiej kolumnie są same „nie”, perfekcyjna optymalizacja pierwszej kolumny nie rozwiązuje najważniejszego problemu: nadal nie wiadomo, dlaczego użytkownik miałby wybrać właśnie ten tekst.
Co zostaje po streszczeniu?
Im łatwiej całą wartość tekstu zamknąć w kilku zdaniach odpowiedzi generatywnej, tym mniej powodów zostaje użytkownikowi, żeby wejść na stronę. Konkurentem poradnika nie jest już tylko inny poradnik. Jest nim również odpowiedź, która wyciąga wspólny mianownik z kilku źródeł i pokazuje go przed pierwszym kliknięciem. Poza streszczeniem zostają rzeczy, które trzeba było zrobić, zmierzyć albo od kogoś usłyszeć. Reszta to surowiec dla AI Overview.